
시스템을 ddr4 128gb에 r9700 2개로 구성해본김에 qwen3.8 27b와 qwen3.8 flash next를 실행해보았다.
QWEN3.8 27B
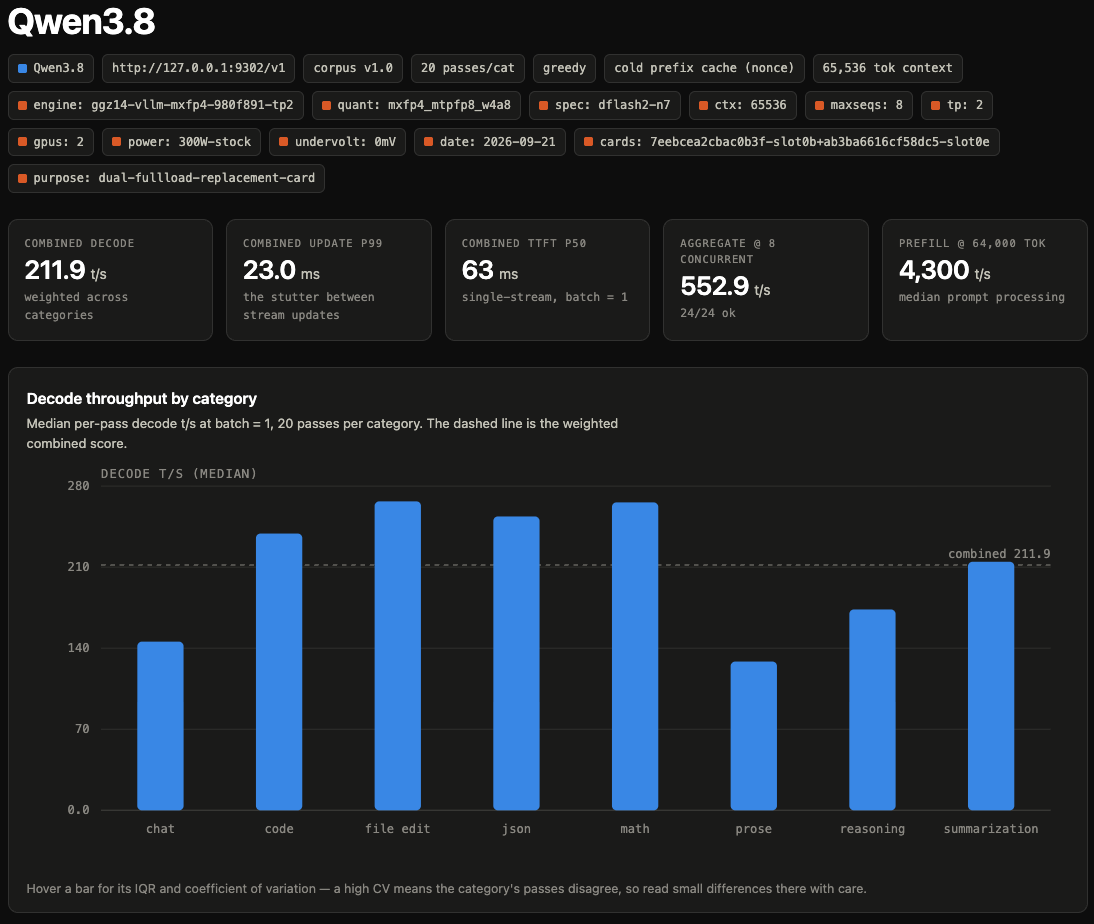
디코드는 212정도가 나오고 프리필은 4300정도가 나온다.
보통 클로드에서 제공하는 오퍼스가 디코드 50~60에 프리필 2000~3000인것에 비하면 꽤나 빠른 수준이다.
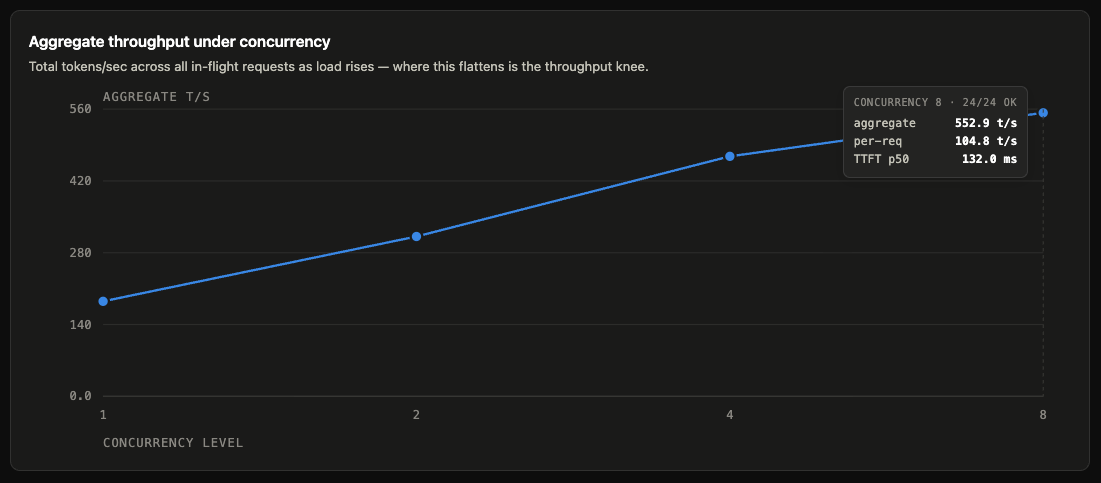
요청당 104.8정도가 맥시멈이고 동시에 8개 실행 시 디코드 합은 553정도까지 나온다.
물론 지능은 클로드가 제공하는 오퍼스보다 한참 부족한 수준이지만 프론티어 모델로부터 작업을 받아 수행하는 정도로는 아주 훌륭하다.
QWEN3.8 FLASH NEXT
다음은 qwen3.8 flash next이다.
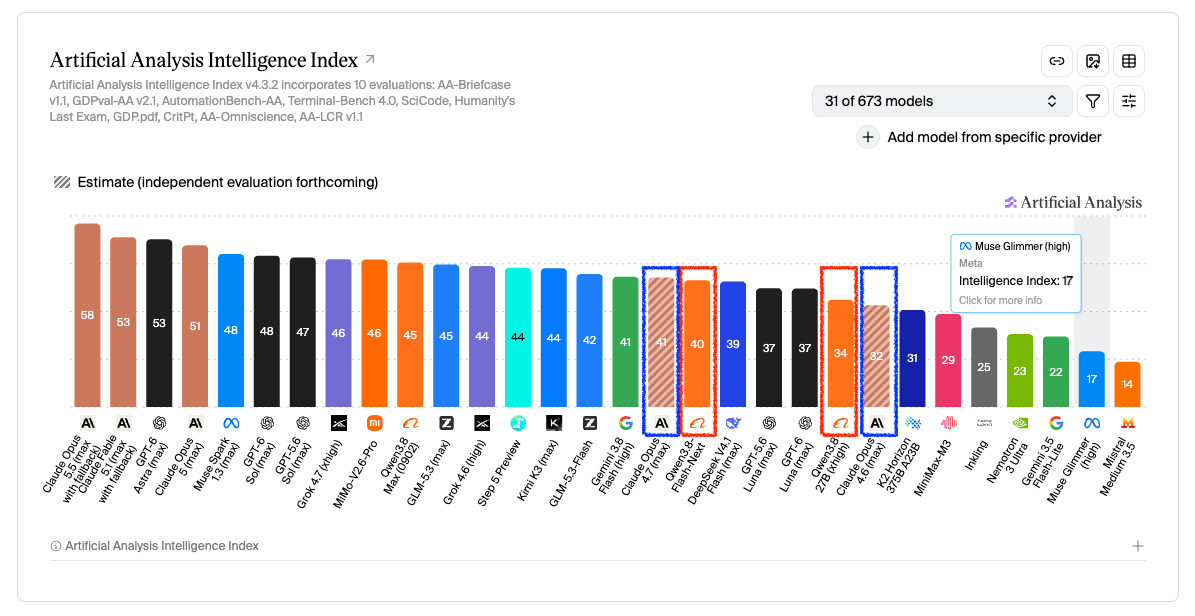
지능은 오퍼스 4.6과 4.7사이로 로컬에서 사용하기 충분한 모델이다.
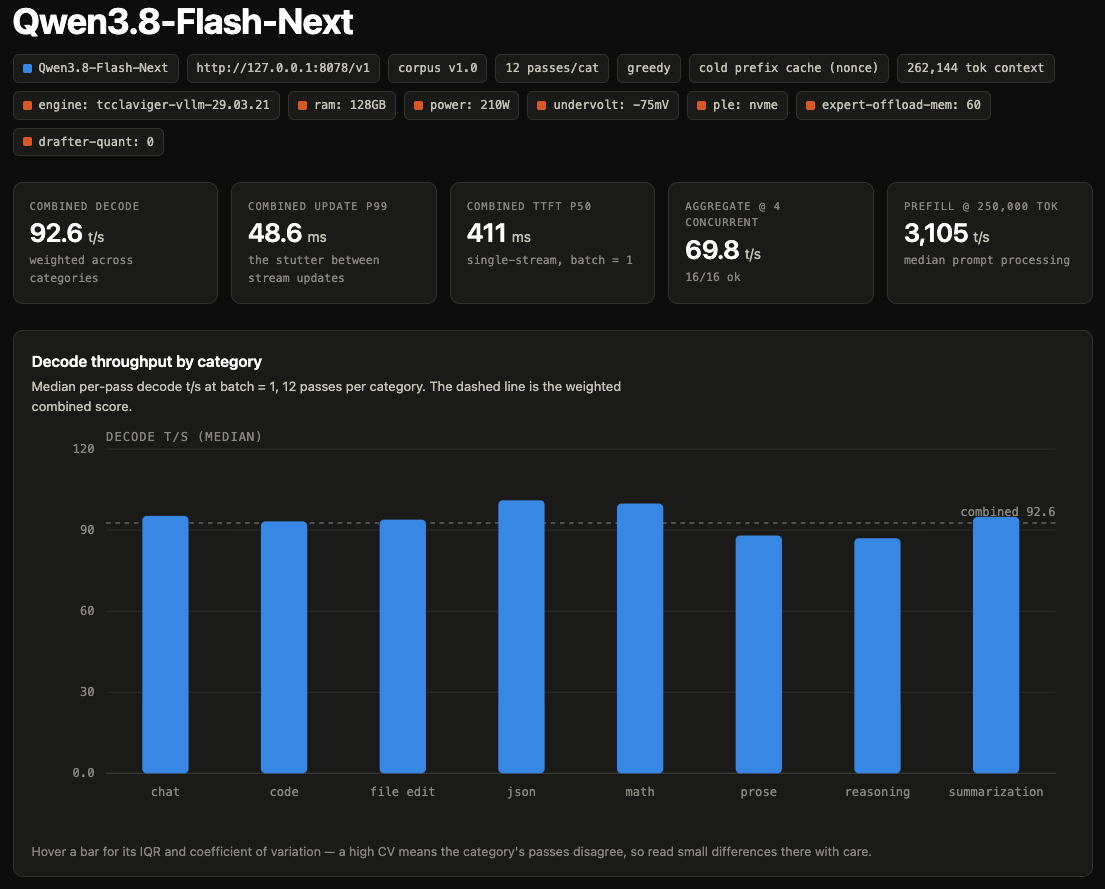
디코드는 92.6이고 프리필은 3105이다.
클로드보다 약간 빠른 수준이라고 할 수 있다.
디코드 총 합은 69.8인데 사실상 맥시멈 동시성 2개가 한계이다.
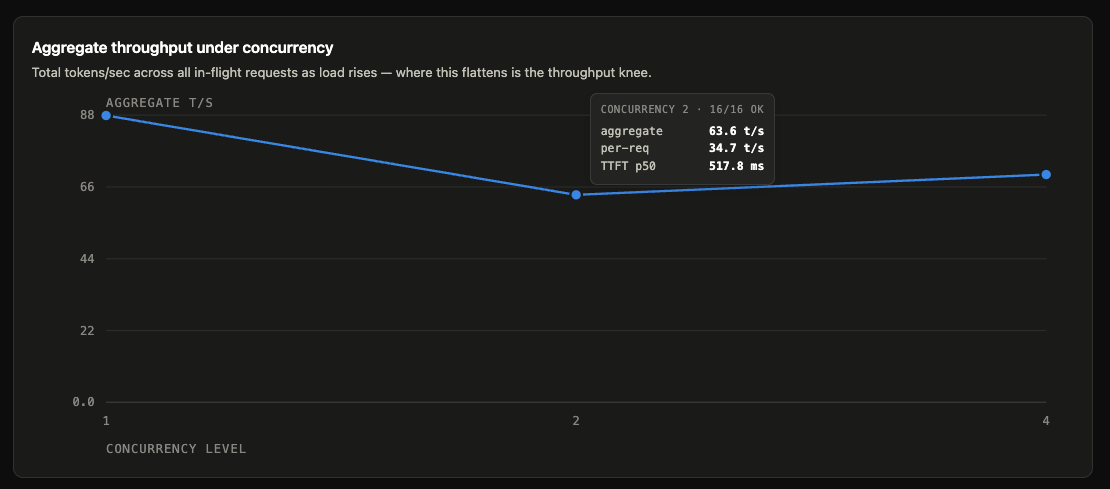
동시에 2개 요청 시 34.7 정도가 나오고 4개부터는 20아래로 내려가서 사용하기 정말 힘들다.
그래서 보통은 단일 세션으로만 사용하기 딱 좋다.
그 외에 다른 문제풀이 벤치마크는 너무 시간이 오래걸려서 포기했다.
'홈서버 > LLM' 카테고리의 다른 글
| [LLM] R9700에서 Qwen3.8-27B를 최대한 빠르게 (0) | 2026.08.29 |
|---|---|
| [LLM] R9700에서 Qwen3.6-27B 벤치마크 (0) | 2026.06.04 |
| [LLM] 로컬 LLM(Qwen3.5 35B&9B) vs OpenRouter, 비용 면에서 뭐가 더 나을까? (2) | 2026.04.04 |
| [LLM] RTX4060Ti 16GB에서 Qwen3.5 35B-A3B Q3 vs 9B Q4, 뭐가 더 나을까? (0) | 2026.03.29 |
| [LLM] Qwen3.5 2B, 4B, 9B, 27B, 35B-A3B 구동 후기 (0) | 2026.03.16 |